一句话结论:Laya 宣称的”校准概率”和”无幻觉结构化决策”,在我们的中文线索筛选场景里基本失效——
noul布尔概率头对所有中文输入都饱和在 1.0,连”长年收黄豆玉米的经纪人”都能判成 100% 命中金融贸易业务。本文所有数据来自实际运行,非道听途说。但先说清楚:这是一次小样本、单任务的非正式评测,结论只对我们的场景负责,不能当作对 Laya 的全面否定。
1. 背景:我们本来想用它干什么
任务很朴素:一张 Excel,几千条采集来的用户记录(nickname 昵称 + subtitle 简介),要筛出从事资金过桥、摆账配资、大宗贸易资金增量业务的目标客户。
选 Laya 的理由看起来很美:
- 421M 小模型,单问题 33ms、批量 7ms/题(T4 实测)
- 不生成文本 → 没有幻觉、不需要解析输出
- 输出校准过的概率和置信度 → 可以直接按阈值自动决策
- 支持
choice/score/noul三种题型,中文有 multilingual 检查点
我们照着官方文档实现了 laya.load() + agent.predict(),结果一跑就发现不对劲。
2. 第一次跑:相关度全是 1.0
上线第一版用 noul 题型算”是否金融贸易业务”的概率,42 条数据里出现大量 1.0,而且得分集中在高位、区分度极差。
其中最刺眼的两个反例(用户实际反馈):
| 昵称 | 简介 | noul 输出 | 真实情况 |
|---|---|---|---|
| 经纪人 | 长年收黄豆。玉米,有需要卖的,买的联糸我,电话13846531540 | 1.000 | 农产品收购经纪人,与金融贸易增量毫无关系 |
| 留学口水菌 | 用最犀利的眼神洞察留学,帮你避开留学中的那些坑!合作V:16601124664 | 1.000 | 留学自媒体,完全无关 |
一个”是不是金融贸易业务”的判断器,对农产品经纪人和留学博主都给出 100% 的肯定——这不是阈值没调好,这是信号本身是坏的。
3. 三个检查点横向对比:都不行
为排除”权重选错了”的可能,我们下载并实测了三个检查点(laya 0.3.4,中文测试用例 5 条,其中 2 条明确目标、3 条明确无关):
3.1 multilingual(官方推荐的中文检查点,约 647MB)
| 测试记录 | noul | choice 分类(置信度) | 四类概率 [资金方/贸易/实体/无关] |
|---|---|---|---|
| 经纪人·收黄豆玉米(无关) | 1.000 ✗ | entity (0.78) | 0.00 / 0.08 / 0.92 / 0.00 |
| 留学口水菌(无关) | 1.000 ✗ | trade (0.85) ✗ | 0.00 / 0.95 / 0.04 / 0.00 |
| 叶辰·亮资摆账过桥(目标) | 0.931 | capital (0.18) | 0.49 / 0.34 / 0.08 / 0.09 |
| 西安私有资金(目标) | 0.999 | entity (0.31) ✗ | 0.08 / 0.22 / 0.65 / 0.05 |
| 某某机械厂(无关) | 0.09 ✓ | entity (0.89) ✓ | 0.00 / 0.02 / 0.97 / 0.01 |
问题:noul 5 条里 4 条饱和在 1.0(含 2 条明确无关);choice 分类把留学博主判成”大宗贸易”(0.95,还很有信心),把”西安私有资金”判成”实体厂家”(0.65)。
3.2 typed-decisions(约 1.1GB)
| 测试记录 | noul | choice 分类(置信度) | 四类概率 |
|---|---|---|---|
| 经纪人(无关) | 0.28 | trade (0.02) | 0.23 / 0.34 / 0.27 / 0.17 |
| 留学口水菌(无关) | 0.28 | capital (0.02) | 0.34 / 0.19 / 0.22 / 0.25 |
| 叶辰(目标) | 0.54 | capital (0.05) | 0.43 / 0.19 / 0.20 / 0.18 |
| 西安私有资金(目标) | 0.59 | capital (0.08) | 0.46 / 0.21 / 0.15 / 0.18 |
| 某某机械厂(无关) | 0.33 | entity (0.03) | 0.25 / 0.24 / 0.35 / 0.16 |
问题:所有选项概率被压平在 0.15~0.46 的窄带里,置信度全线 0.02~0.08。表面上”不饱和了”,实际上是没有任何判别力——目标记录和无关记录的概率分布几乎重叠,分数排序基本等于随机。
3.3 english-root(英文根检查点,约 808MB)
| 测试记录 | noul | choice 分类(置信度) | 四类概率 |
|---|---|---|---|
| 经纪人(无关) | 0.95 ✗ | entity (0.08) | 0.18 / 0.27 / 0.43 / 0.12 |
| 留学口水菌(无关) | 0.96 ✗ | entity (0.06) | 0.28 / 0.20 / 0.40 / 0.12 |
| 叶辰(目标) | 0.95 | capital (0.08) | 0.40 / 0.16 / 0.32 / 0.12 |
| 西安私有资金(目标) | 0.89 | capital (0.09) | 0.48 / 0.21 / 0.19 / 0.12 |
| 某某机械厂(无关) | 0.76 ✗ | entity (0.19) | 0.14 / 0.16 / 0.59 / 0.11 |
问题:noul 又饱和(0.76~0.96,连机械厂都 0.76),置信度全线低于 0.2。
3.4 小结:换权重救不了
三个检查点,同一个病:noul 头对中文几乎恒为高分,choice 头要么误判要么没区分度,置信度数值不具备可解释性。 这不是调参问题,是模型中文能力的天花板。
4. 排除”是不是我们用法不对”
在给 Laya 判死刑前,我们逐一验证了常见的”是不是你用法错了”:
| 假设 | 实验 | 结果 |
|---|---|---|
| state 格式不对(JSON 字典 vs 纯文本) | 分别传 {"nickname":...,"subtitle":...} 和 "昵称:xxx;简介:xxx" | 两条无关记录都输出 1.000,格式无影响 |
| instructions 用中文导致失效 | 换成英文 instructions | 无关记录仍是 1.000;更糟的是”叶辰·亮资摆账过桥”从 0.931 掉到 0.076(方向都反了) |
| criteria 描述不够清楚 | 在 criteria 里加入负例提示(”留学中介、农产品收购、零售不是大宗贸易”) | 有效:留学博主从 trade 0.95 → other 0.46 ✓;但”叶辰·亮资摆账过桥”从 capital 0.49 掉到 other 0.35 ✗(按下葫芦浮起瓢) |
结论:格式和语言不是主因;criteria 提示能局部改善,但在小模型上表现为零和的打地鼠——修好一个案例,另一个案例就退化。
5. 最终跑通的方案(绕过而不是解决)
既然 noul 不可用,我们改成用 choice 的目标类型概率求和当相关分:
1 | score = probs["capital"] + probs["trade"] # 相关分 = P(资金方) + P(大宗贸易) |
实测效果(真实 laya 推理,非 mock):
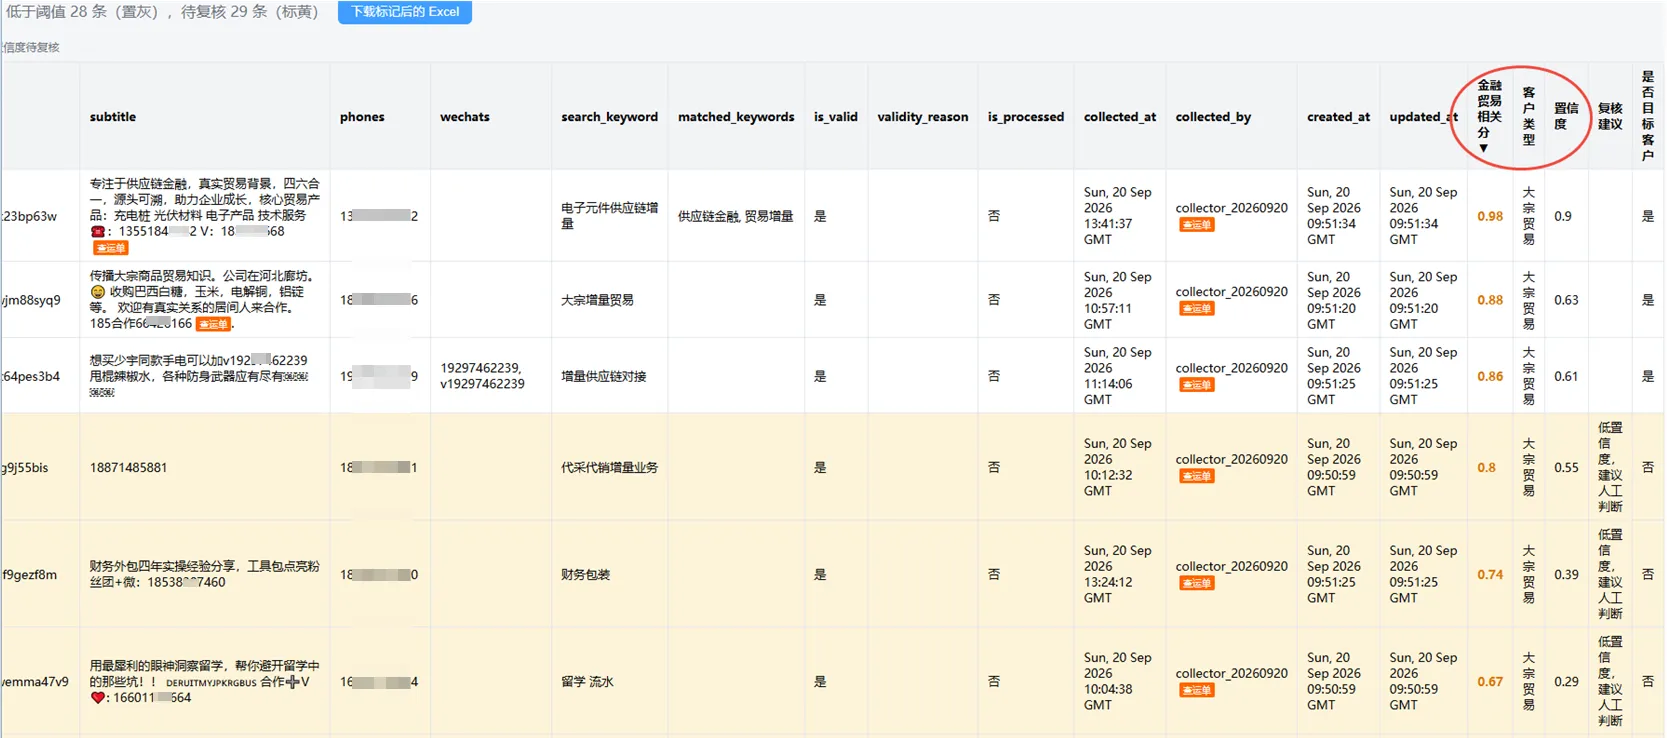
| 记录 | 相关分 | 分类 | 置信度 | 判定 |
|---|---|---|---|---|
| 充电桩供应链贸易增量 | 0.98 | 大宗贸易 | 0.90 | ✅ 目标客户 |
| 叶辰·亮资摆账过桥 | 0.54 | 资金方 | 0.02 | ⚠️ 待复核 |
| 留学口水菌 | 0.51 | 大宗贸易 | 0.13 | ⚠️ 待复核 |
| 西安私有资金 | 0.13 | 实体厂家 | 0.54 | ❌ 排除 |
| 经纪人·收黄豆玉米 | 0.04 | 实体厂家 | 0.86 | ❌ 排除 |
| 某某机械厂 | 0.01 | 实体厂家 | 0.96 | ❌ 排除 |
分数终于拉开了(0.01 ~ 0.98),两条明确无关的记录被正确排除。但注意:真正命中的目标(叶辰、留学误判)都是靠”置信度极低 → 转人工复核”兜住的,而不是靠模型判对。说白了,这个方案的价值在于它知道自己不知道。
6. 该泼的冷水:别迷信评测数字
6.1 宣传指标 ≠ 你的场景指标
| 官方宣传 | 我们的实测 |
|---|---|
| “校准的布尔概率 P(true)” | 中文输入下 P(true) 恒为 1.0,校准性为零 |
| “无幻觉、结构化输出” | 输出确实结构化,但结构里填的是错的——不幻觉 ≠ 正确 |
| “多语种支持 100+ 语言” | 支持 ≠ 可用。中文语义判断能力明显弱于宣传暗示 |
| “7ms/题” | 速度是真的,快得毫无意义——快速给出错误答案 |
结构化输出最大的陷阱:它让错误答案看起来像正确答案。如果输出是一段自然语言,你一眼能看出荒谬;但输出是 {"noul": 1.0, "confidence": 0.85} 时,它会伪装成可信数据,直接流进你的自动化决策。
6.2 自己搭评测,别信榜单
任何”模型能力评测”都应该在你的真实数据上做,至少:
- 建 20~50 条黄金集:明确正例、明确反例、边界案例各占一部分,人工标注
- 看区分度,不看绝对值:正例分数分布和反例分数分布是否分离?重叠区多大?(我们这一步就发现
noul完全重叠) - 看置信度分布:置信度高的样本是否真的更准?如果高置信度也大量出错,这个字段就是装饰品
- 做扰动测试:换个输入格式、换个措辞、加个错别字,结论还稳吗?(我们的 criteria 敏感度测试就是这一步,暴露了打地鼠现象)
- 警惕饱和:如果大量输出挤在 0.0 或 1.0,说明模型在这个分布上没学会,阈值再调也是徒劳
6.3 什么场景可以用,什么场景别碰
可以用:
- 英文文本的分类/路由(官方主场景,ModernBERT 的强项)
- 大批量粗筛的第一道漏斗(把明显无关的先去掉,剩下的给人看)
- 需要极低延迟、本地部署、无 API 成本的场景
- 输出只作参考、有下游人工校验的环节
别碰:
- 中文语义判断直接驱动自动决策(我们的场景)
- 任何”分数超过阈值就自动执行动作”的闭环
- 需要解释性和可追溯的合规场景
- 把置信度当作可靠性的场景
6.4 我们的建议
- 中文业务场景:优先考虑成熟的中文 LLM(GLM / Qwen / DeepSeek 等)的结构化输出,配合 JSON Schema 约束。成本比小模型高,但准确率不在一个量级
- 如果坚持用 Laya:只把它当粗筛漏斗,所有”目标客户”判定必须过人工复核;用
choice概率而不是noul;置信度门槛设高一点(我们设 0.6) - 框架可以复用:我们的 Flask + pandas + 双色标记 + Excel 导出框架与推理引擎解耦,换引擎只需改
evaluate_batch()一个函数
7. 免责与致谢
- 样本量:本文核心结论基于 5~6 条测试用例 + 42 条真实数据的一次筛选,属于探索性测试,不构成严格评测
- 版本:laya 0.3.4,multilingual / typed-decisions / english-root 三个检查点
- 任务单一:只测了”中文线索分类”一个任务,Laya 在其他任务(英文工单分派、内容审核等)上可能表现正常
- 态度:我们无意否定 Laya 这个项目——421M 做到这个推理速度,工程上很有价值。但”模型卡上的漂亮指标”和”你的业务能不能用”之间,隔着一整套你必须在自己的数据上做的验证。这盆冷水不是泼给 Laya,是泼给”看到 benchmark 就敢上生产”的我们自己。
8. 效果提升与后续优化建议
针对前述实测中暴露的“微型系统一模型难以处理高度垂直的中文口语化场景(如亮资摆账)”等问题,如果要真正在业务中落地并提升线索筛选效果,建议从以下三个维度进行架构与策略优化:
8.1 数据预处理:降低模型认知负荷
小模型(421M)的注意力机制极易被无关噪音带偏。原始数据中的微信号、电话号码往往会干扰模型的特征匹配。
- 正则去噪:在将
nickname和subtitle传入模型前,务必先在代码层用正则剔除所有手机号、微信号及无意义的前缀/符号(如\/x:、合作V:)。让模型只吃纯粹的业务语义文本。 - 字段融合:如果原始数据是结构化表格,避免生硬的 JSON 键值对传递,可尝试将关键字段拼接成自然陈述句(例如:“昵称是XX,简介为XX”),以增强上下文语义连贯性。
8.2 调用策略优化:顺应“系统一”的直觉特性
- 避免负向排他(Prompt 减负):测试表明在
criteria中加入“农产品收购不是大宗贸易”等排除逻辑会导致准确率的“打地鼠”现象。因此,应放弃让小模型做复杂的逻辑排斥,仅保留正向特征描述(例如直接写明:“包含资金托盘、摆账、过桥、验资等明确的资金方业务描述”)。 - 多维求和兜底:继续沿用之前跑通的方案,彻底放弃易饱和的
noul真伪判断,改用choice题型的目标概率求和(如P(资金方) + P(大宗贸易))来计算相关分。 - 严格实施置信度门控(Confidence-gated):坚持置信度兜底策略,设定严格的双阈值过滤(如
得分 > 0.8且confidence > 0.8才判定通过),其余低置信度数据一律视作“模型无法确定”并挂起。
8.3 混合路由架构(Hybrid Routing)
不要试图用单一的小模型解决全部核心业务问题,工业界的常规做法是构建三层漏斗架构:
- 规则词典层(绝对准确,零耗时):建立包含“亮资、摆账、贴息、过桥”等强金融属性黑话的正则规则库。命中词库直接判定为目标客户,无需调用 AI。
- Laya 粗筛层(低成本过滤):接管未命中规则的存量数据,利用 Laya 极低延迟的优势,快速淘汰极为明显的无关客户(如纯农业种植、医疗代办等)。
- 成熟 LLM 兜底层(解决长尾与疑难杂症):对于 Laya 给出“低置信度”或处于及格线边缘的数据,调用成熟的千亿级中文大模型(如 Qwen / GLM / DeepSeek),配合严格的 JSON Schema 进行二次判决,确保最终的业务召回率。
测试脚本与可复现代码见同目录 lavaDemo.py,完整改造教程见 lavaDemo教程.md。